
- Ab etwa 30 Milliarden Parametern wird lokale KI schnell teuer: Du brauchst entweder eine potente Grafikkarte mit viel Videospeicher (VRAM) oder ein Gerät mit viel gemeinsam genutztem Arbeitsspeicher (Unified Memory).
- Reicht der Videospeicher nicht aus und das Modell muss auf normalen Arbeitsspeicher ausweichen, wird es 5- bis 20-mal langsamer.
- Bei sehr langen Texten, komplexem Werkzeug-Einsatz (Tool-Use) und Spitzen-Reasoning liegen Cloud-Modelle wie Claude, GPT, Gemini oder DeepSeek weiterhin vorn.
- Für viele Alltagsaufgaben – Spracherkennung, Smart-Home-Steuerung, einfachere Textarbeit – reicht lokale Hardware inzwischen locker aus.
Lokale KI ist erwachsen geworden – aber nicht grenzenlos
Wer sich ein Homelab aufbaut, kommt früher oder später an den Punkt, an dem er sich fragt: Reicht meine eigene Hardware für ein eigenes KI-Modell, oder lohnt sich doch ein Cloud-Dienst wie ChatGPT oder Claude? Die ehrliche Antwort: beides hat seinen Platz. Die Qualitätslücke zwischen offenen, lokal betreibbaren Modellen (etwa Qwen3, DeepSeek V3 oder Llama 4) und den geschlossenen Spitzenmodellen ist 2025/2026 deutlich kleiner geworden. Trotzdem gibt es klare Grenzen, an denen lokale Hardware kapituliert oder unwirtschaftlich wird.
Die erste Grenze: Speicher, Speicher, Speicher
Ein KI-Modell besteht aus Milliarden Zahlenwerten, die bei der Texterzeugung ständig durchgerechnet werden müssen. Damit das schnell geht, müssen sie im VRAM liegen – dem Videospeicher der Grafikkarte, der viel schneller angebunden ist als normaler Arbeitsspeicher. Wie viel VRAM du brauchst, hängt von der Modellgröße und der sogenannten Quantisierung ab – dabei werden die Zahlenwerte des Modells vergröbert, damit sie weniger Platz brauchen, meist ohne dass die Antwortqualität stark leidet.
- 7–8 Milliarden Parameter (kurz: 7–8B): 4-Bit-quantisiert ca. 6–8 GB VRAM, 8-Bit ca. 10–14 GB
- 14B: rund 12 GB
- 24B: rund 16 GB
- 32B: rund 24 GB
- 70B: rund 40 GB VRAM (bei der gängigen Q4_K_M-Quantisierung)
Reicht der VRAM nicht aus und das System weicht auf den normalen Arbeitsspeicher (RAM) aus, sinkt die Geschwindigkeit um den Faktor 5 bis 20. Aus einer Antwort, die in Sekunden kommt, werden dann Minuten. Genau das passiert auch, wenn man ein Sprachmodell auf einem gewöhnlichen NAS (Network Attached Storage, ein Speicher, der am Netzwerk hängt) ohne eigene Grafikkarte laufen lässt: Ein 7B-Modell schafft dort nur 0,5 bis 1 Token pro Sekunde – für 200 Tokens Antwort wartest du 3 bis 7 Minuten. Für den gelegentlichen Chat mag das gehen, für ernsthafte Nutzung ist es unbrauchbar.
Welche Hardware für welche Modellgröße
Für alles ab etwa 30B Parametern führt kaum ein Weg an dedizierter Hardware vorbei. Zur Einordnung eine Übersicht der gängigen Optionen:
| Hardware | Speicher | Richtpreis | Besonderheit |
|---|---|---|---|
| Gebrauchte RTX 3090 | 24 GB GDDR6X, 936 GB/s Bandbreite | $600–850 | 2026 bestes VRAM-pro-Euro-Verhältnis, Einstieg für 30B+ |
| RTX 4090 | 24 GB | ca. $1.599 neu | Schneller, z. B. 20–25 Tokens/s bei einem 34B-Modell in Q4 |
| RTX 5090 | 32 GB GDDR7 | $1.999–2.199 | Etwas mehr Spielraum nach oben |
| NVIDIA DGX Spark | 128 GB Unified Memory | ab $4.699 (Stand Feb. 2026) | Große Modelle ohne Rack-Server, Preis seit Marktstart mehrfach gestiegen |
| Mac Studio M3 Ultra | bis 96 GB (Neugeräte seit März 2026 gedeckelt) | – | Leise, aber bandbreitenlimitiert (819 GB/s) |
| AMD-Strix-Halo-Mini-PC (z. B. Framework Desktop) | 128 GB Unified Memory | $1.999 | Lädt 70B-Modelle komplett, günstigster Einstieg in diese Klasse |
Wichtig für Einsteiger: Mehr Speicherkapazität heißt nicht automatisch mehr Tempo. Systeme mit Unified Memory – also gemeinsam genutztem Speicher für Prozessor und Grafikeinheit, wie beim Mac Studio oder den AMD-Strix-Halo-Geräten – können zwar große Modelle vollständig laden, sind dabei aber durch ihre Speicherbandbreite begrenzt und liefern oft weniger Tokens pro Sekunde als eine dedizierte Grafikkarte mit gleicher Kapazität.
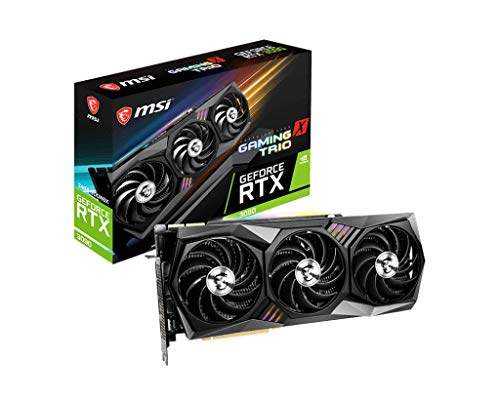
MSI Gaming GeForce RTX 3090 24GB (Renewed)
24 GB Videospeicher sind für Modelle bis in den 30B-Bereich genau die Größe, an der lokale KI erfahrungsgemäß spürbar an Fahrt gewinnt. Als Renewed-Angebot mit Garantie liegt der Preis spürbar über dem gebrauchter Karten vom Privatmarkt aus der Tabelle oben.
Die zweite Grenze: Kontext, Reasoning und Werkzeuge
Neben dem reinen Rechenaufwand gibt es einen Bereich, in dem die Cloud aktuell klar vorn liegt: das Kontextfenster, also wie viel Text sich ein Modell auf einmal „merken“ kann, während es antwortet. Cloud-Flaggschiffe wie Claude, GPT, Gemini oder DeepSeek bieten inzwischen standardmäßig 1 Million Tokens und mehr an Kontext. Lokale Modelle laufen meist mit 4.000 bis 16.000 Tokens, nur einzelne Ausnahmen wie Qwen 2.5-1M erreichen die Million. Wer also ein ganzes Buch, ein umfangreiches Codeprojekt oder eine lange Dokumentensammlung auf einmal analysieren lassen will, stößt lokal schneller an Grenzen als in der Cloud.
Ähnliches gilt für komplexes Tool-Use – also wenn ein Modell selbstständig externe Werkzeuge aufruft, etwa um im Internet zu suchen oder mehrstufige Aufgaben zu planen – und für Spitzen-Reasoning bei besonders kniffligen Problemen. Hier ist der Abstand zwischen offenen und geschlossenen Modellen 2025/2026 zwar spürbar geschrumpft, aber nicht verschwunden.
Wann die Cloud die bessere Wahl ist
Cloud-Dienste lohnen sich vor allem dann, wenn:
- du nur gelegentlich rechnest und keine eigene Hardware anschaffen willst,
- du sehr lange Dokumente oder Codebasen auf einmal verarbeiten musst,
- du auf dem allerneuesten Stand bei Reasoning und Tool-Use sein willst,
- oder wenn dir laufende Stromkosten wichtiger sind als eine Einmalinvestition – eine Workstation mit einer RTX 4090 zieht unter Last rund 600 Watt, eine H100 rund 700 Watt, was bei Dauerbetrieb auf etwa 15 Kilowattstunden pro Tag und Grafikkarte hinausläuft.
Die Preise für Cloud-Modelle sind 2025/2026 zudem stark gefallen, was die Rechnung zusätzlich zugunsten der Cloud verschiebt, wenn du nur sporadisch KI nutzt.
Wo lokale KI längst reicht – und sogar besser ist
Umgekehrt gibt es Bereiche, in denen lokale Lösungen der Cloud nicht nur ebenbürtig, sondern vorzuziehen sind. Für die Sprachsteuerung im Smart Home läuft Home Assistant „Assist“ seit 2023 komplett lokal und ohne Cloud-Anbindung; seit Version 2025.5 lässt sich zusätzlich ein Sprachmodell einbinden, und die Anfang 2025 eingeführte Funktion „Speech-to-Phrase“ liefert auf einem Raspberry Pi 5 eine Reaktionszeit von nur rund 150 Millisekunden.
Für Spracherkennung eignet sich OpenAIs Whisper: Die „turbo“-Variante braucht nur rund 6 statt 10 GB Videospeicher wie large-v3, ist etwa 8-mal schneller und kommt qualitativ nah an large-v2 heran. Und mit gpt-oss-20b hat OpenAI im August 2025 erstmals seit GPT-2 wieder ein offenes Modell veröffentlicht, das in nur 16 GB Speicher läuft – die größere Variante gpt-oss-120b passt sogar auf eine einzelne High-End-Recheneinheit vom Typ H100.
Ein Wort zur Sicherheit
Ein verbreiteter Irrtum lautet: „Lokal ist automatisch sicherer und privater.“ Das stimmt so pauschal nicht. In einem GGUF-Modell-Lader (dem Format, in dem viele lokale Modelle vorliegen) von Ollama wurde eine Sicherheitslücke bekannt, die unauthentifizierten Zugriff auf Prozessspeicher erlaubt haben soll – darunter potenziell API-Schlüssel, Prompts und Verlauf. Details wie CVE-Nummer und Patch-Stand sind nicht abschließend verifiziert, aber die Lücke zeigt: Auch lokale Software hat eigene Angriffsflächen und will genauso gepflegt werden wie jeder Cloud-Dienst.
Fazit: Kombinieren statt entscheiden
Die realistischste Antwort ist selten „nur lokal“ oder „nur Cloud“, sondern eine Mischung. Für Smart-Home-Sprachsteuerung, Transkription oder Standardaufgaben mit Modellen bis etwa 30B Parametern lohnt sich eigene Hardware – ob eine gebrauchte RTX 3090, ein Mini-PC mit AMD Strix Halo oder, bei Bedarf nach noch mehr Speicher, ein DGX Spark oder Mac Studio. Werkzeuge wie Ollama oder LM Studio machen den Einstieg mittlerweile einfach, beide bieten inzwischen sogar optionale Cloud-Anbindung für den Fall, dass die eigene Hardware nicht ausreicht. Für sehr lange Kontexte, komplexes Tool-Use oder wenn es auf jede Sekunde ankommt, bleibt die Cloud vorerst die verlässlichere Wahl.